Kurumsal Yapay Zeka: Büyük Dil Modellerini Ölçeklendirme ve Etkin Yönetim Stratejileri
Kurumsal Yapay Zeka: Büyük Resme Odaklanmak
Büyük dil modelleri (BDB) ve üretken yapay zeka artık sadece araştırma laboratuvarlarının konusu değil. Günümüz iş dünyasında, bu teknolojiler somut değerler yaratmaya, operasyonel verimliliği artırmaya ve yeni iş modelleri geliştirmeye hazır. Ancak, bir BDB'yi laboratuvar ortamından alıp kurumsal bir yapıya entegre etmek, sadece bir API entegrasyonundan çok daha fazlasını gerektiriyor. Burada anahtar kelimeler: ölçeklenebilirlik, maliyet etkinliği ve model yaşam döngüsünün etkin yönetimi. Bir yazılımcı olarak biliyoruz ki, bir prototipi çalıştırmak kolaydır, ama onu milyonlarca kullanıcıya sunmak ve yıllarca ayakta tutmak bambaşka bir mühendislik disiplini ister.
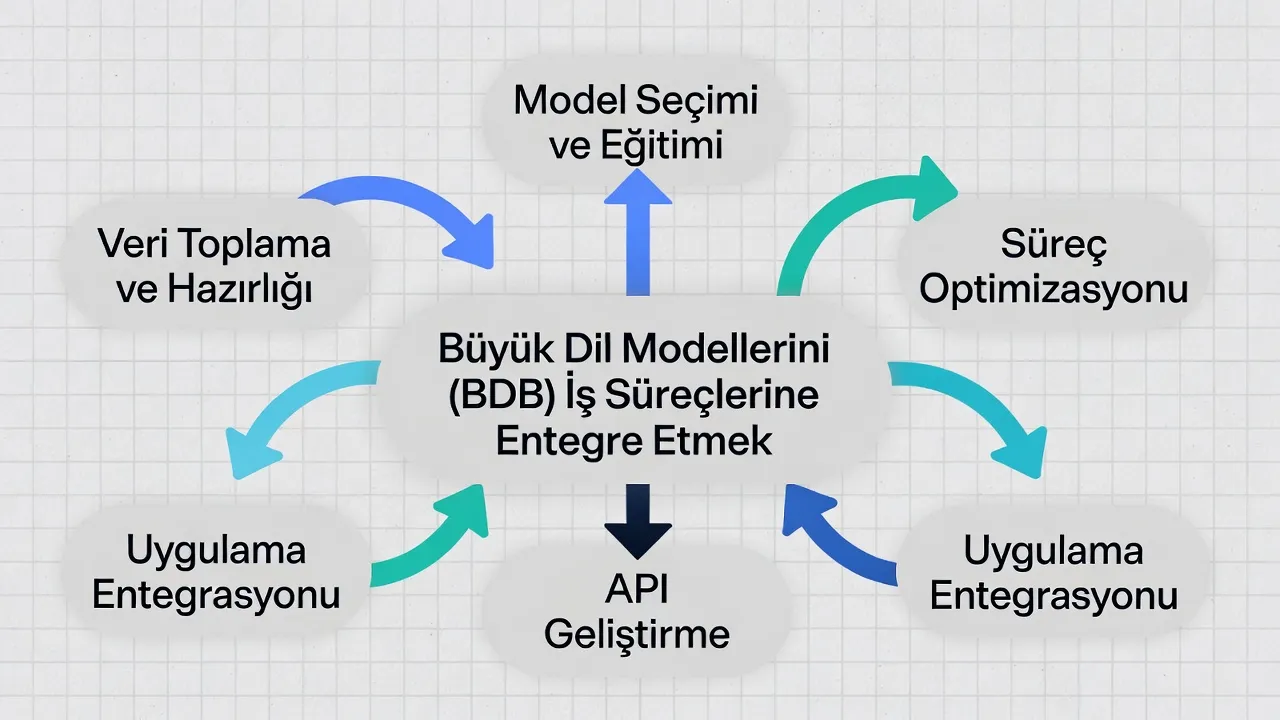
Büyük Dil Modellerini (BDB) İş Süreçlerine Entegre Etmek
Nereden Başlamalı? Stratejik Yaklaşım
Her büyük teknoloji dönüşümünde olduğu gibi, BDB entegrasyonunda da doğru başlangıç noktası kritik. Öncelikle, iş süreçlerinizde BDB'lerin gerçek bir problem çözebileceği veya belirgin bir değer katabileceği alanları net olarak tanımlayın. Bir müşteri hizmetleri chatbot'u mu, içerik üretimi mi, yoksa kod tamamlama araçları mı? Küçük, yönetilebilir projelerle başlayıp, elde ettiğiniz başarıları genişletmek, hem riskleri azaltır hem de organizasyon içinde bir güven ortamı oluşturur.
Entegrasyon Desenleri ve Mimariler
BDB'leri entegre ederken birkaç ana mimari desen karşımıza çıkıyor:
- API Entegrasyonları: OpenAI, Azure AI, Google Gemini gibi bulut tabanlı sağlayıcıların API'lerini kullanmak en hızlı ve kolay başlangıç yoludur. Maliyet, performans ve veri güvenliği açısından sağlayıcı bağımlılıklarını iyi değerlendirmek gerek.
- On-premise/Self-hosted Modeller: Güvenlik hassasiyeti yüksek, regülasyonlara tabi sektörlerde veya yüksek hacimli ve düşük maliyetli çıkarım ihtiyacı olan durumlarda modelleri kendi altyapınızda barındırmak mantıklı olabilir. Bu, daha fazla operasyonel yük anlamına gelse de, tam kontrol ve özelleştirme imkanı sunar.
- RAG (Retrieval Augmented Generation) Mimarisi: BDB'lerin güncel veya şirket içi özel verilerle sınırlı kalması temel bir problem. RAG mimarisi, harici bir bilgi tabanından (dokümanlar, veritabanları, şirket içi wiki'ler) ilgili bilgiyi alıp BDB'ye bağlam (context) olarak sunarak bu sorunu çözer. Bu, genellikle vektör veritabanları, indeksleme ve akıllı bilgi alma algoritmaları gerektirir. Şirket içi bilgiyi BDB'ye aktarmanın en etkili yolu budur.
Veri ve Arayüz Ayrımı: Kritik Bir Adım
Yapay zeka uygulamalarında sürdürülebilirlik ve esneklik için Veri ve Arayüz Ayrımı temel bir prensiptir. BDB'ler, temel dil anlama ve üretim yeteneklerini sağlarken, bu yetenekleri besleyen veri kaynakları ve son kullanıcıyla etkileşimi sağlayan arayüzler birbirinden bağımsız olmalı. Bu sayede:
- Veri kaynakları değiştiğinde veya güncellendiğinde, BDB ve arayüz katmanları minimum etkiyle çalışmaya devam eder.
- Arayüzler (mobil uygulamalar, web tabanlı chatbotlar, dahili araçlar) farklı teknolojilerle geliştirilebilir ve BDB'den bağımsız olarak evrimleşebilir.
- Yeni bir BDB'ye geçiş veya birden fazla model kullanma ihtiyacı doğduğunda mimari daha esnek kalır.
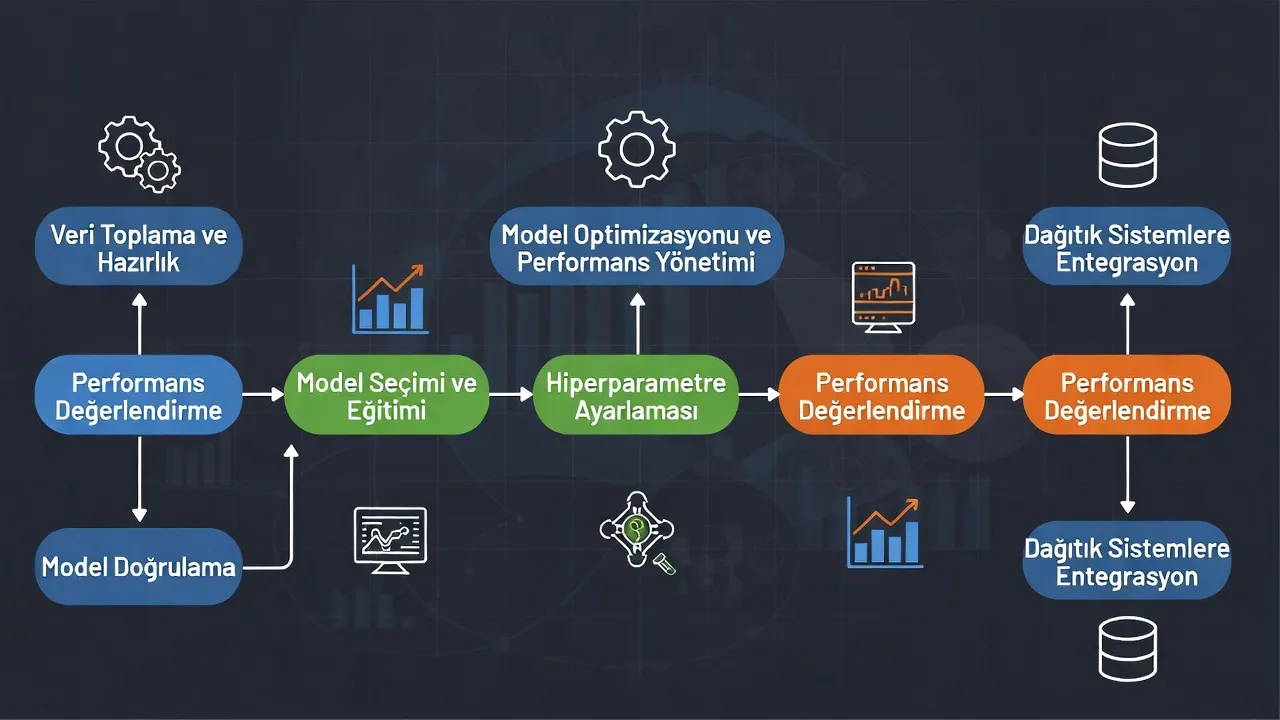
Model Optimizasyonu ve Performans Yönetimi
Bir BDB'yi sadece çalıştırmak yetmez, onu verimli ve maliyet etkin bir şekilde çalıştırmak gerekir.
Maliyet ve Kaynak Verimliliği
Büyük dil modellerinin API çağrıları veya kendi altyapınızda çalıştırdığınızda tükettikleri kaynaklar (GPU, bellek) ciddi maliyetlere yol açabilir. Optimizasyon stratejileri şunları içermeli:
- Model Seçimi: Her iş yükü için en büyük modele ihtiyacınız olmayabilir. Bazen daha küçük, domain'e özel fine-tuned modeller, genel amaçlı büyük modellerden daha iyi performans gösterir ve çok daha uygun maliyetlidir.
- Token Maliyetleri: Prompt'larınızı ve modelin ürettiği çıktıları olabildiğince kısa ve öz tutun. Token kullanımını optimize eden prompt mühendisliği teknikleri geliştirin.
- Niceliklendirme (Quantization) ve Damıtma (Distillation): Kendi barındırdığınız modeller için, niceliklendirme ile model boyutunu ve çıkarım süresini azaltabilir, damıtma ile büyük bir modelin bilgisini daha küçük bir modele aktararak performans/maliyet dengesini sağlayabilirsiniz.
Model İnce Ayarı (Fine-tuning) ve Alan Adaptasyonu
Genel amaçlı BDB'ler her zaman sizin spesifik iş alanınızın jargonunu, kültürel nüanslarını veya şirket içi kurallarınızı bilemez. Kendi verilerinizle (müşteri etkileşimleri, ürün belgeleri, şirket politikaları) modelleri ince ayarlamak (fine-tuning), modelin alanınızdaki doğruluğunu ve uygunluğunu artırır. Bu süreç, transfer öğrenmenin güçlü bir uygulamasıdır ve modelin belirli bir göreve veya domain'e adaptasyonunu hızlandırır.
Çıkarım Optimizasyonu (Inference Optimization)
Modelin gerçek zamanlı olarak tahmin üretme süreci (çıkarım), uygulamanızın genel kullanıcı deneyimini doğrudan etkiler. Çıkarım performansını artırmak için:
- GPU Hızlandırma ve Özel Donanım: Özellikle kendi altyapınızda çalıştırıyorsanız, TensorRT gibi kütüphanelerle GPU hızlandırması veya özel çıkarım çipleri (NVIDIA Triton Inference Server) kullanmak performansı katlar.
- Batching ve Caching: Birden fazla isteği tek seferde işlemek (batching) ve sık kullanılan çıktıları önbelleğe almak (caching), gecikmeyi azaltır ve işlem yükünü hafifletir.
- Serverless Yaklaşımlar: Yük dalgalanmaları olan uygulamalar için, serverless (fonksiyon tabanlı) çıkarım hizmetleri esneklik ve maliyet etkinliği sağlayabilir.
Etkin Model Yaşam Döngüsü Yönetimi (MLOps)
Bir yapay zeka uygulamasının başarılı olması, modelin sadece geliştirilmesiyle bitmez. Modelin sürekli olarak izlenmesi, sürümlemesi, dağıtılması ve gerektiğinde yeniden eğitilmesi gerekir. Bu sürece MLOps (Machine Learning Operations) diyoruz.
Model Sürümleme ve Takibi
Yazılım dünyasında kod için Git neyse, model yönetimi için de benzer versiyonlama mekanizmalarına ihtiyaç var. Hangi modelin hangi veriyle eğitildiğini, hangi performans metriklerine sahip olduğunu takip etmek hayati. DVC (Data Version Control) gibi araçlar, veri setlerini ve modelleri versiyonlamanıza yardımcı olurken, MLflow gibi platformlar deneyleri, modelleri ve dağıtımları izlemek için merkezi bir yapı sunar. Bu, özellikle farklı model versiyonlarını A/B test ederken veya sorunları giderirken paha biçilmezdir.
Otomatik Dağıtım ve İzleme
CI/CD (Sürekli Entegrasyon/Sürekli Dağıtım) prensipleri MLOps'a da uygulanır. Modelinizi otomatik olarak test ortamlarına ve oradan da üretim ortamına dağıtmak, insan hatasını azaltır ve dağıtım hızını artırır. Modeller canlıya alındıktan sonra, performanslarını (gecikme, hata oranları, doğruluk), kaynak kullanımlarını ve en önemlisi 'model drift'ini (veri dağılımının zamanla değişmesi ve modelin performansının düşmesi) sürekli izlemek gerekir. Anormal durumlar için uyarı sistemleri kurmak, proaktif müdahale sağlar.
Yeniden Eğitim (Retraining) ve Model Drift
Veri değişimi kaçınılmazdır. Yeni terimler ortaya çıkar, kullanıcı davranışları değişir, pazar dinamikleri farklılaşır. Bu durum, model drift'e yol açarak modelinizin zamanla daha az doğru tahminler yapmasına neden olur. Otomatik tetiklenen yeniden eğitim döngüleri, yeni verilerle modellerin güncel kalmasını sağlar. Ancak, her yeniden eğitimin dikkatli yönetilmesi, yeni modelin performansının eskiyle karşılaştırılması ve bir 'human-in-the-loop' (insan kontrolü) mekanizmasıyla onaylanması önemlidir.
Config-Driven Mimari ile Yönetim Kolaylığı
Karmaşık yapay zeka sistemlerinde, farklı modelleri, parametreleri, entegrasyon ayarlarını ve dağıtım stratejilerini kod içinde yönetmek hızla içinden çıkılmaz hale gelebilir. İşte tam burada Config-Driven mimari devreye giriyor. Modelleri, onların hangi kaynakları kullanacağını, hangi eşik değerlerine göre tetikleneceğini veya hangi RAG stratejisini uygulayacağını basit yapılandırma dosyaları (JSON, YAML) üzerinden yönetmek:
- Esnekliği artırır: Kod değiştirmeden model davranışını güncelleyebilirsiniz.
- Bakım maliyetini düşürür: Farklı ekipler aynı model tanımını kullanabilir.
- Hataları azaltır: Parametreleri görsel arayüzler veya basit metin dosyalarıyla yönetmek, kodda hard-code etmekten daha güvenlidir.
Geliştirme Hızını Artırmak: Pratik Araçlar ve Yaklaşımlar
React Şablonları ve Ön Yüz Gelişimi
Yapay zeka modellerinin son kullanıcıya ulaşması genellikle interaktif arayüzler aracılığıyla olur. Bu arayüzleri hızlı ve verimli bir şekilde geliştirmek için React şablonları paha biçilmezdir. Hazır bileşenler, responsive tasarımlar ve önceden tanımlanmış kullanıcı akışları ile prototipleme ve üretim aşamasında zaman kazanılır. Özellikle chatbot, sanal asistan veya veri görselleştirme arayüzleri gibi yapay zeka odaklı uygulamalarda bu şablonlar, geliştiricilere büyük kolaylık sağlar.
NeonLab Bileşenleri ile Hızlı Entegrasyon
Birçok kurumsal yapay zeka uygulamasında karşılaşılan ortak zorluklar vardır: veri entegrasyonu, model API'lerini sarmalama, hata yönetimi ve kullanıcı arayüzü bileşenleri. NeonLab bileşenleri, bu tür tekrar eden görevleri ve entegrasyon ihtiyaçlarını karşılamak üzere tasarlanmış, yeniden kullanılabilir ve optimize edilmiş yazılım parçaları sunar. Bu bileşenler sayesinde, geliştiriciler tekerleği yeniden icat etmek yerine, doğrudan iş mantığına ve özgün değer yaratmaya odaklanabilirler. Örneğin, bir vektör veritabanı entegrasyonu, BDB çıktılarını işleme veya özel bir doğrulama mantığı gibi özellikler için hazır NeonLab bileşenleri kullanılabilir.
Sonuç: Kurumsal Yapay Zeka Bir Yolculuktur
Kurumsal yapay zeka uygulamalarını ölçeklendirmek ve etkin bir şekilde yönetmek, tek seferlik bir proje değil, sürekli adaptasyon, optimizasyon ve öğrenme gerektiren bir yolculuktur. Teknoloji hızla gelişirken, organizasyonların çevik kalması, doğru stratejilerle ilerlemesi ve sağlam mühendislik prensiplerini uygulaması gerekir. Unutmayın, en iyi model, sadece en iyi performansı gösteren değil, aynı zamanda en sürdürülebilir ve yönetilebilir olandır.